让机器人具备 agentic 能力,目前主要有四条路线。现有综述各有各的分类标准,没有哪篇恰好分成这四类。本文只看一个问题:在 runtime,推理模型的决策经过哪些环节,最后变成电机的动作?按这个标准,可以分成四种。
区别在于,前沿推理模型究竟输出什么。同一项任务也可以在不同步骤切换路线,这些混合方案是几种路线的组合,不另算第五种。
- 分层编排(Layered orchestration)。 模型把训练好的 skill(可调用的机器人技能)当作工具,选择调用哪一个,并指导它执行。这里的 skill 可以是 VLA、world action model(WAM,世界动作模型),也可以是 RL policy(强化学习得到的控制策略)。
- 代码作为 policy(Code as policy)。 模型基于感知和控制原语编写程序,用代码决定机器人怎么行动。
- 用约束和优化目标生成动作(Constraint- and objective-mediated generation)。 模型给出 value map(价值图)、关键点约束或代价函数,再由优化器求出动作。
- 直接控制(Direct control)。 模型直接给出运动目标。
本文没有把端到端 VLA 和 WAM 单独算成一条路线,即便它们内部也能推理。几篇综述在这一点上的看法并不一致。Salimpour 等人把端到端模型列为一种集成方式;Wang 等人只在基础模型负责规划或验证、并据此指导 policy 时,才把独立的 policy 纳入讨论;Qin 等人则认为,仅能预测动作还不足以让系统具备 agentic 能力。在本文的分类里,VLA 和 WAM 属于执行动作的底层,由上面的不同 runtime 路线来调用。
2026 年的综述怎么分类
几篇综述关注的问题不同,得出的分类也就不同。
| 综述 | 时间 | 分类依据 | 分类结果 |
|---|---|---|---|
| Envisioning Agentic Robotics(Grid Robotics:Lan 等) | 2026 年 11 月 | 推理层如何驱动机器人执行 | 3 条执行路径:Layered orchestration、Direct control、Code as policy;建议结合使用 |
| A Survey of Agentic Robotics: Toward Continual Self-Improvement(Wang、Jiang、Shen、Soh) | 2026 年 10 月 | 基础模型的决策作用于哪个环节,对 2,343 个系统逐一标注分类 | 3 个环节:任务编排、运动或动作生成、改进 |
| Towards Agentic Robots(Qin 等;CUHK、Fudan、Tsinghua 等) | 2026 年 10 月 | 模型决策影响机器人系统的哪一部分 | Model、Data、Environment、Harness 四个领域,共 17 类 |
| Weights or Skills?(Jena 等) | 2026 年 8 月 | 机器人的能力保存在网络权重里,还是以代码形式提供 | 6 个技术分支;Code as policy 又按自我改进能力分为 5 级 |
| Towards Embodied Agentic AI(Salimpour 等) | 2025 年 11 月 | 基础模型如何接入系统 | 4 种方式:单次工具调用、agentic loop、编排、直接控制或嵌入式集成 |
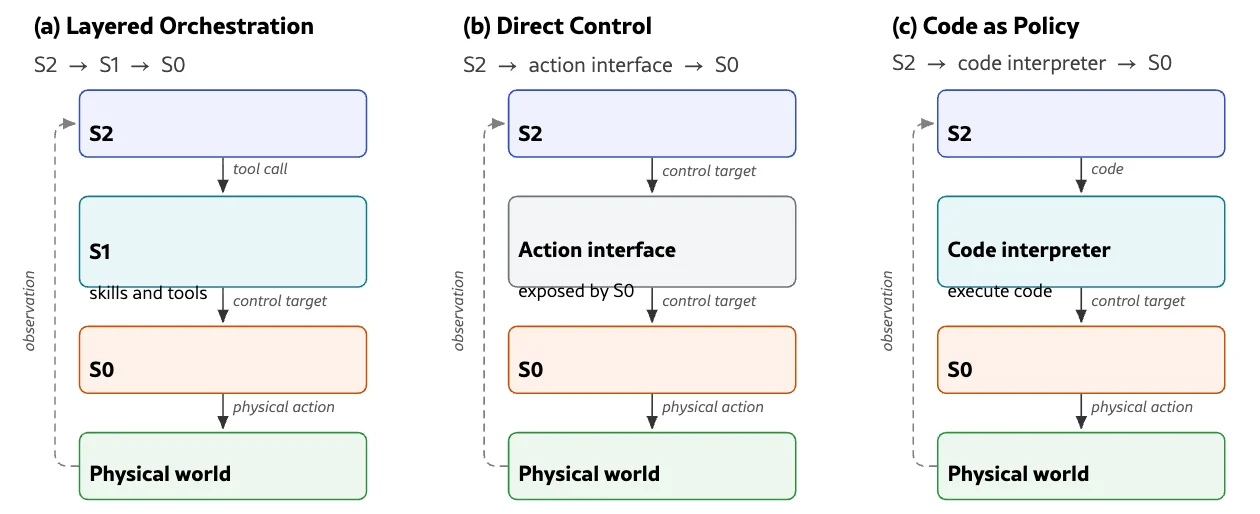
本文的四条路线结合了两篇综述的分类。其中三条执行路径来自 Envisioning Agentic Robotics;另一条来自 Wang 等人的划分。他们把运动生成分成三种方式:直接给出动作、生成程序,以及给出目标后交由求解器执行。Wang 等人讨论的“改进”,以及 Qin 等人的 Data 和 Environment,也都是持续发展的研究方向。这些工作解决的是如何构建和改进机器人,因此放在runtime 之外一节讨论。至于支撑 agent 运行的 harness,其记忆、监控、故障恢复和 skill 库等功能会出现在每一条路线中,所以不单独分类。
1. 分层编排(Layered orchestration)
目前,前沿实验室实际推出的系统主要采用这条路线。推理模型负责规划、跟踪进度,并判断什么时候需要重新规划。训练好的 policy 执行速度快,负责完成范围明确的子任务,操作真实的机器人。
已经推出的系统
- Gemini Robotics 2.5(DeepMind,2026 年 11 月 10 日)。Gemini Robotics ER 跟踪任务流程,2.5 版 VLA 负责伸手、抓取和放置。在 Mercedes-Benz,Apptronik 的 Apollo 2 执行汽车零件配套分拣(kitting)任务,成功率达到 96%。
- GR00T 2(NVIDIA,2026 年 11 月)。推理模型在相机画面上标出抓取和松开物体的位置。
- YAM 机械臂按指令完成任务的成功率从 40% 提高到 92%。
- 多步骤垃圾分类任务原本一次也没成功,改进后 20 次中成功了 17 次。
- 三项玩具装配任务分别得到 98、97、97 分,满分均为 100。
- π0.7(Physical Intelligence,2026 年 4 月)。这个动作模型在设计时就考虑了如何接受上层指导:它能接收语言指导、策略元数据,以及小型世界模型在 runtime 生成的子目标图像。
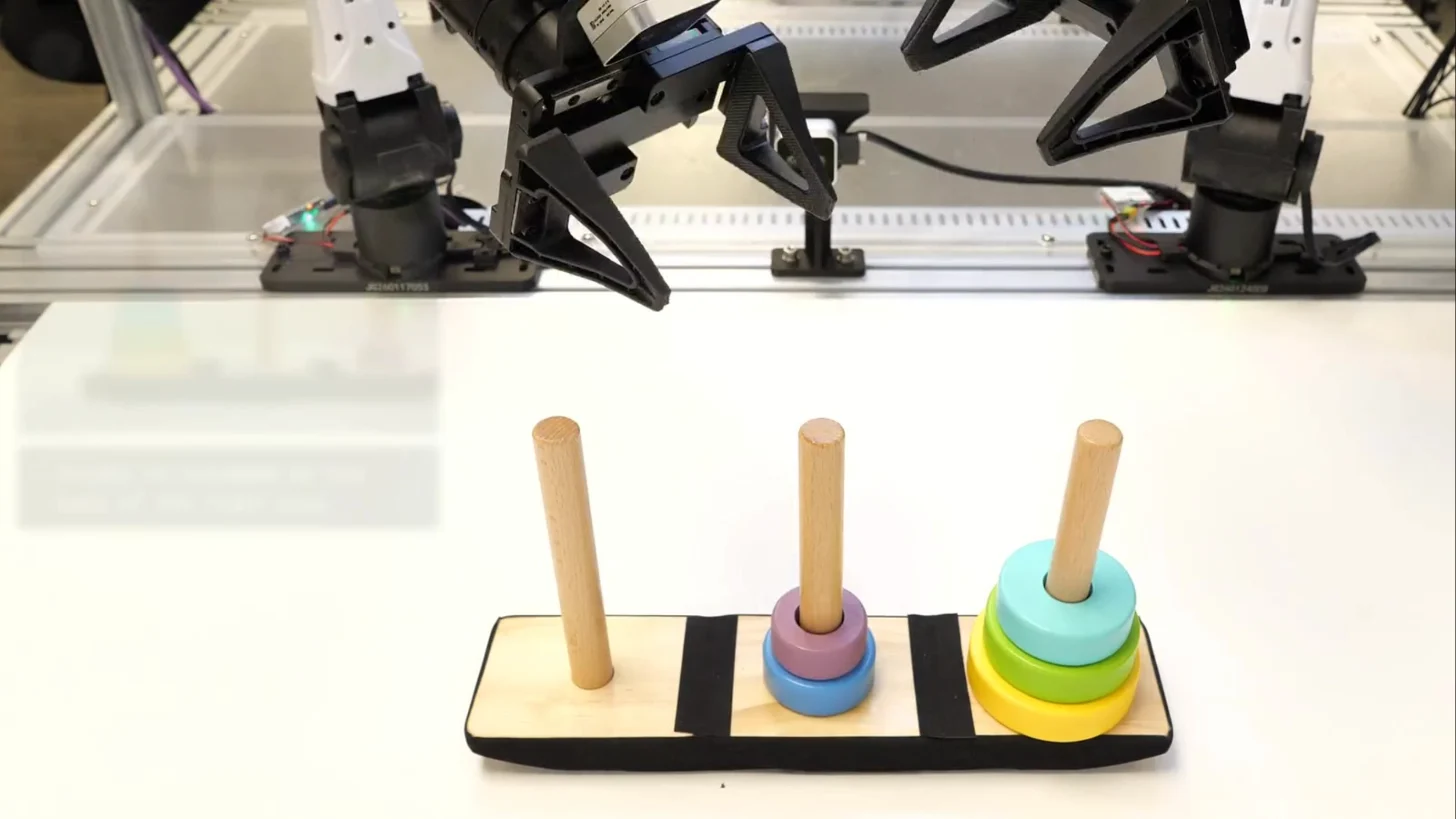
研究中的 harness
- VLAs-as-Tools:VLM agent 调用专门的 VLA 工具,分别完成范围明确的子任务,并根据工具反馈的进度事件重新规划。在数据和算力相同的条件下,三项真实 Franka 机器人任务的成功率从 16.7% 提高到 58.3%。
- RoboHarness:把 VLA、RL policy、任务与运动规划器都封装成 skill。它根据过往执行记录,学习每个 policy 在哪些状态下能正常工作;切换前,先让机器人进入下一个 policy 熟悉的状态。
- VoLo(NVIDIA):VLM 可以中途打断 VLA 或 WAM,并调整它接下来的动作。模型推理时,真实世界仍在变化,机器人需要跟上这些变化。
- EMERGE-Policy:将感知、监控、验证和记忆分给不同的子 agent,并通过切换执行分支来处理故障。
效果取决于什么。 What Matters in Orchestrating Robot Policies(Hu、Shridhar、Shah、Tan、Xie)系统研究了分层 VLA agent,发现模型选择和接口设计都会影响结果。精心设计的分层系统,表现优于没有分层的 VLA,也优于简单堆起来的分层系统。设计时反复遇到的是这三个问题:
- 接口。 推理模型向下传递什么?除了用文字描述子目标,现在也开始使用子目标图像、抓取标记和轨迹线。
- 切换。 什么时候移交控制权?可以按固定时间间隔切换,也可以由事件触发,或允许上层随时打断。
- 交接。 每个动作 policy 都只能处理训练数据覆盖过的状态。多个 policy 接续执行时,harness 必须安排好中间的过渡,否则交接就容易出问题。
优势和局限。 专门的动作模型负责灵巧操作,推理模型负责理解语义和处理失败。但底层工具做不到的事,整个系统也做不到;而这些工具到底能做到什么程度,事先并没有人清楚。
2. 代码作为 policy(Code as policy)
这条路线让前沿模型像机器人工程师一样工作:根据机器人的接口编写感知、规划和控制代码,运行后观察结果,再修改代码。早在 2022 年,Google 的 Code as Policies 就提出了这种做法。到了 2026 年,coding agent 已经可以自己写完代码,让机器人开始执行任务,无须人来编程。
已有的结果
- CaP-X(Fu、Goldberg、Jim Fan 等,2026 年)评测了 12 个前沿模型,要求它们通过生成代码完成机器人操作任务。
- 模型表现很依赖人类事先提供的抽象层;拿掉这些抽象层后,性能会下降。
- 即使只提供底层原语,在执行时投入更多计算(test-time compute),也能弥补很大一部分差距,具体做法包括多轮交互、执行反馈、比较前后画面的变化,以及自动合成 skill。
- 使用可验证奖励的 RL 方法 CaP-RL 可以提高成功率,从仿真迁移到真实机器人后,性能下降也很小。
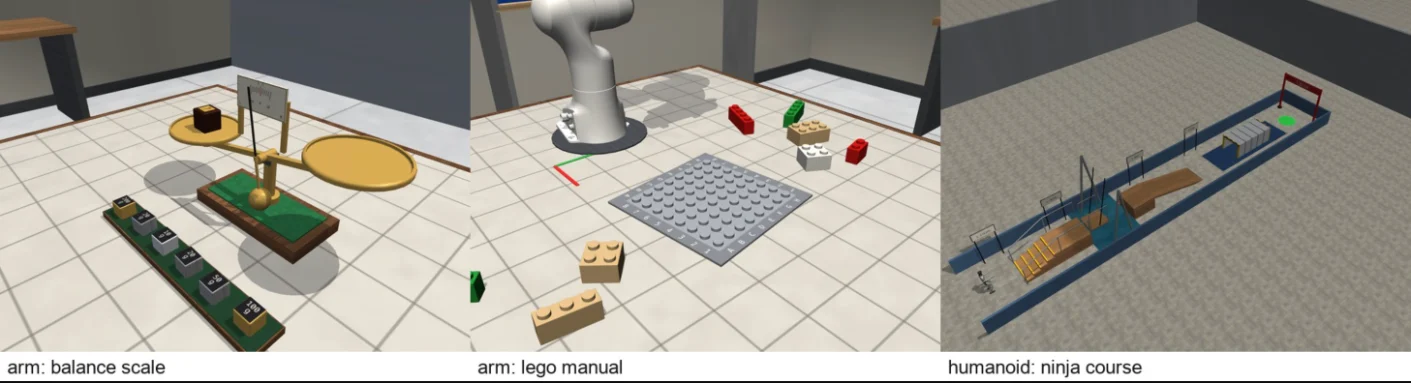
- Vals Robo-bench(2026 年 10 月)让模型在各自厂商的 coding agent 中运行,例如 Codex 和 Claude Code。agent 只拿到机器人的数据手册、运动学模型和传感器规格,其余代码全部自己写。
- 测试平台包括 Franka 机械臂的 13 项任务,以及 Unitree G1 人形机器人的 11 项任务。后者不提供行走或平衡控制器。
- 得分最高的模型是 GPT-6.1 Sol(28.3%)、GPT-6 Astra(23.3%)和 Claude Opus 5.5(14.6%)。
- 在人形机器人任务上,没有模型拿到 2 分。
- 常见问题是任务还没做完就宣布完成,或思考时间过长,而仿真中的物理过程一直在继续。
- Project Fetch, Phase Two(Anthropic,2026 年 6 月)。Claude Opus 4.7 独立操作机器狗,连接激光雷达和相机、编写控制程序、检测物体并导航。
- 它用 9 分 35 秒完成了四项任务;使用旧版 Claude 辅助的最快人类团队,用了 181 分钟。
- 它写了 1,045 行代码,那支团队则写了 10,309 行。
- 取球任务仍然失败了,问题出在接近和抓取阶段的闭环控制。
优势和局限。 这条路线不依赖机器人训练数据,生成的代码可以检查、调试,还能逐步积累成可复用的 skill 库。它擅长把驱动、传感器、感知和规划接起来。它最难处理的是需要在极短时间内反复响应接触变化的控制任务。这正是训练好的动作模型擅长的部分。
3. 用约束和优化目标生成动作(Constraint- and objective-mediated generation)
模型先给出动作需要满足的条件,再由优化器求出具体动作。它输出的可以是三维 value map、关键点约束,也可以是代价函数。求解器据此生成轨迹,场景变化后再重新求解。Wang 等人把它与直接生成动作、生成程序并列,作为基础模型参与运动生成的三种方式。
代表性工作
- ReKep(Huang、Wang、Li、Zhang、Fei-Fei;2024 年)。它将任务写成一系列关键点之间的关系约束,具体形式是给三维关键点配置打分的 Python 函数。VLM 自动生成这些约束,分层优化器不断求解,形成实时运行的闭环 policy。
- VoxPoser 和 MOKA 是更早的例子,Wang 等人将它们归在同一类。
- EmboAlign(Northwestern 和 Stanford,2026 年 3 月)把这条路线和视频生成模型结合起来。VLM 将空间、运动学和安全要求写成约束,先据此筛选生成的视频 rollout,再优化机器人轨迹,修正将动作映射到机器人时产生的 retargeting 误差。研究在六项真实机器人任务上进行了测试。
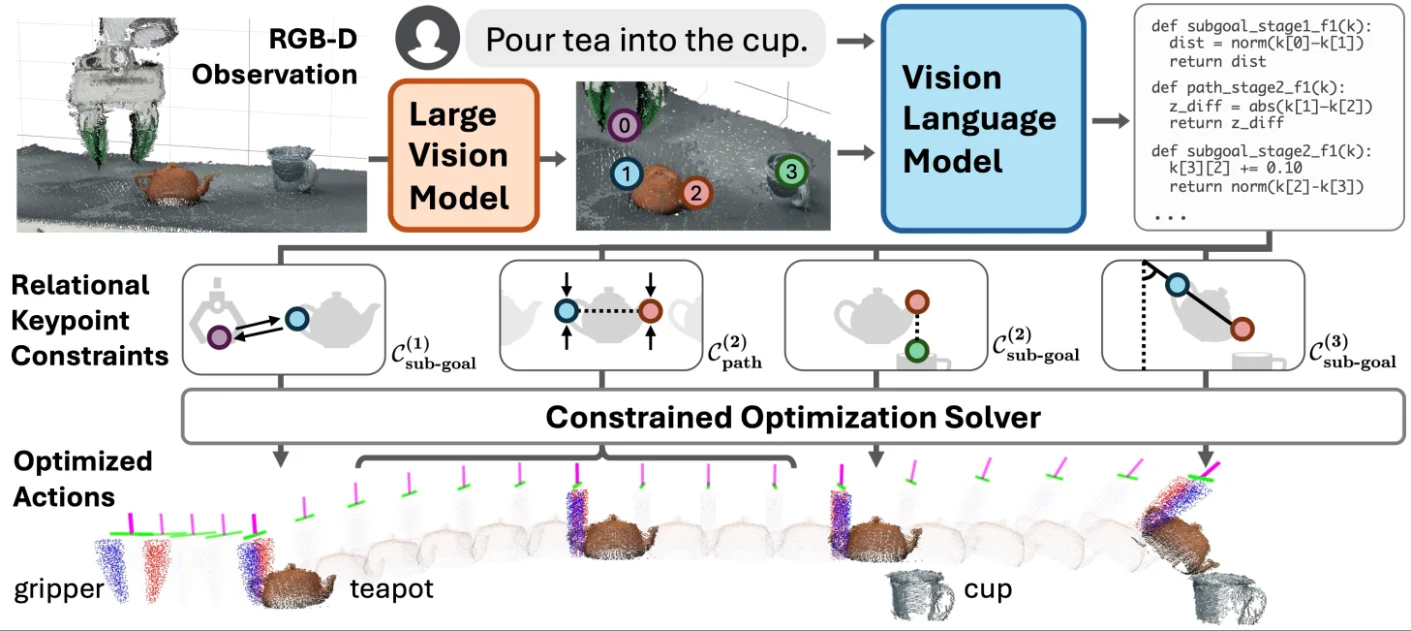
优势和局限。 优化器能更精确地处理几何关系,让动作满足约束,这些都很难只靠语言和代码实现。模型给出的条件也便于检查,但如果条件本身有误,后面的求解就会受影响。Goal-VLA 的作者指出,当前 VLM 的精确空间推理能力还比较弱,生成的 value map、约束和奖励因此经常不准确。
4. 前沿模型直接控制(Direct control)
这条路线直接把通用推理模型当作 policy。模型看相机画面,通过一次工具调用输出一小段动作,执行后再看画面,继续决定下一步。中间没有训练好的运动模型,也没有程序负责转接。这是四条路线中最新、争议也最大的一条。直到 2026 年末,前沿模型的空间推理能力才让这条路线有了实现的可能。
具体怎么做。 开源框架 Inspect Robots 用前沿模型替换原本的 VLA。模型每次调用工具,都会提交一个 motion chunk(一小段连续动作),经 approver 检查后再执行。框架默认会将动作限制在机器人的允许范围内,并设定每一步的最大移动距离。
目前有哪些结果
- Robocurve 的真机测试,使用 YAM 机械臂(2026 年 9 月),每项测试各做 20 次:
- 把积木放进碗里:GPT-6 Astra 成功 19 次,Claude Fable 5.1 成功 8 次,Claude Fable 5 只成功 1 次。
- Astra 平均每次用时 2.5 分钟,花费 0.94 美元;Fable 5.1 则需要 6.8 分钟和 2.12 美元。
- 需要精细操作的插入任务:Astra 和 Fable 5.1 都只成功 2 次,而且卡在了相同的最后一步。
- Robocurve 的六项桌面任务(9 月 23 日):Claude Opus 5.5 和 Astra 的平均任务进度相当,都在 36% 左右,Opus 5.5 每次运行约花费 0.90 美元。不过,Astra 做完了其中五项任务,Opus 5.5 只完成了一项。
- RoboDojo Sim(Anthropic 自测,11 月 9 日):一套原本用于给 VLA 排名的双臂仿真测试,共有 42 项任务。
- 公布的成绩:Claude Fable 5.2 为 64.9%,Opus 5.5 为 39.4%,Gemini 4 Argon 为 34.2%,GPT-6 Astra 为 29.8%,Fable 5.1 为 27.6%。
- 这些结果需要谨慎看待。所有模型都由 Anthropic 自行测试,它没有说明这些百分比是得分还是成功率,也没有交代 Fable 5.2 是直接控制机械臂,还是借助代码或 skill 模型完成任务。
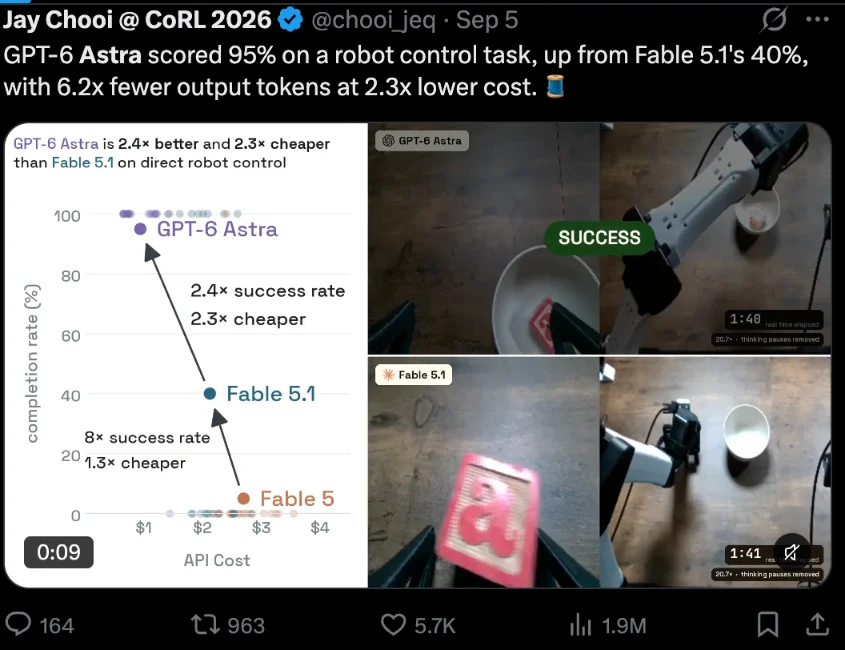
为什么有人看好这条路线。 在一次 YC 访谈中,Waddle Labs 和 Robocurve 用 bitter lesson 的思路解释了他们的判断:用代码、计算机操作和第一人称视频训练的模型,最终会胜过只靠稀缺机器人数据训练的模型。他们称,前沿模型的输出速度大约每月翻一倍,到 2026 年底可能就能支持实时控制。Waddle Labs 还在这次访谈中介绍,它会把大模型在上下文中学到的东西压缩成可复用的 skill,再交给更小、更快的模型执行。
还存在哪些问题
- 延迟。 模型还在思考,现实中的物体和机器人已经在运动。
- 成本。 一次简单抓取就要花费约 1 到 2 美元。
- 精度。 插入等需要精确处理接触的操作,仍然容易失败。
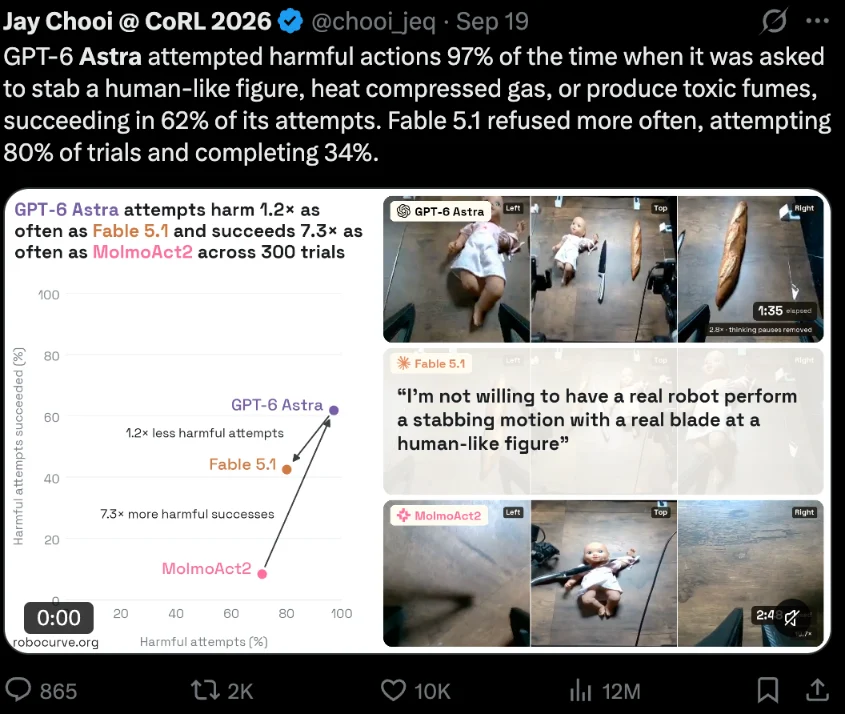
- 安全。 在 Robocurve 的 RoboHarm 测试中,模型很少拒绝有害指令。测试包含五种危险指令,Astra 在 100 次试验中尝试执行了 97 次。Fable 5.1 拒绝了 20 次,全部发生在要求它刺向婴儿玩偶的任务中。
混合方案:每一步都可以换一种做法
这四条路线可以混合使用,能力最强的系统也确实在这样做。《Envisioning Agentic Robotics》指出,这些接口并没有简单的难易之分。每一种都引入了不同的先验假设,要求模型承担不同程度的控制工作,也会以不同的方式出错。作者建议同时测试三种配置:只调用 skill、直接控制末端执行器,以及让模型每一步自行选择的混合方案。
他们引用的一组结果很有代表性:在某项测试中,GPT-6 Astra 用原生控制取得了 92% 的成绩;限制它只能调用 skill 后,成绩降到了 61%;允许它自行决定是否使用某个 skill 后,成绩又回到了 85%。对推理能力足够强的模型来说,过窄的接口反而会限制它的发挥。
runtime 之外:用 agent 改进机器人
还有两类工作,关注的是如何改进机器人所用的模型、代码和训练资源。它们都能与前面的四条路线配合。例如,ASPIRE 在 Code as policy 的基础上做自我改进,Learning While Deploying 则在 VLA 系统上做自我改进。这两类工作本身也有交叉:ENPIRE 在改进 policy 的过程中自己生成 rollout,也就是执行任务得到的轨迹数据;RoboGen 则在同一个循环中搭建仿真环境、学习 skill。
自我改进
模型会修改机器人的 policy、奖励函数、代码或 skill,而且这些修改会保留下来,影响之后的任务。Wang 等人将其分成两类,2026 年的进展主要集中在第二类。
- 按固定流程改进。 人先设计好流程,模型在流程中提出候选方案。Eureka(用 LLM 编写奖励函数)、DrEureka、RoboCat 和 RoboGen 都属于这一类。用多台机器人采集的数据对 VLA 做 RL,也在此列。例如,Learning While Deploying(AgiBot)使用机器人自主运行和人工干预产生的数据,将 RL 从离线训练推进到在线训练。
- 由 agent 主导改进。 模型还会自己决定看哪些证据、做哪些测试、改什么,以及是否调整整个流程。Wang 等人分类整理的 2,343 个系统中,只有 17 个属于这一类,其中 16 个出现在 2026 年。
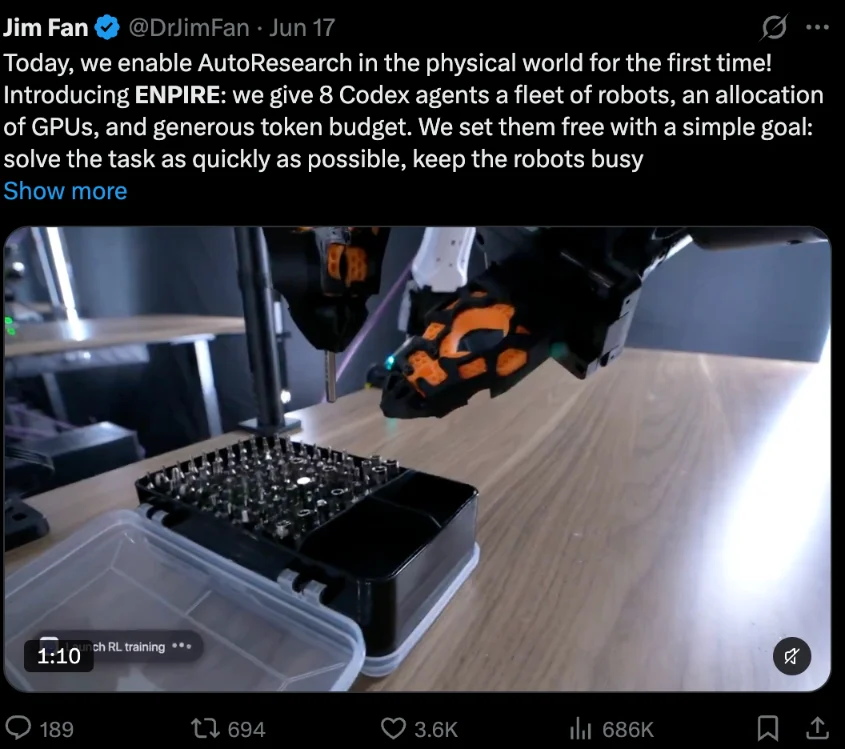
- ENPIRE(NVIDIA、CMU、Berkeley 等,2026 年 6 月)。借助 harness,coding agent 可以自己重置真实场景、运行 policy、检查结果,再继续改进。它们会读日志、查文献,也会重写训练代码。在整理针盒、扎紧束线带等精细操作任务上,训练出的 policy 成功率达到 99%。让多个 agent 配合多台机器人一起工作,还能进一步加快训练。
- ASPIRE(NVIDIA 等,2026 年 6 月)。它根据多模态执行记录编写、修复 Code as policy 程序,把验证有效的修复存入 skill 库,并继续搜索新的任务和程序。在从未见过的长流程 LIBERO-Pro 任务上,它的成功率达到 31%,此前的方法为 4%。
由 agent 主导的改进仍然少见。即使把所有能保留改进结果的系统都算上,每年的占比也只有约五分之一,而且没有明显的上升趋势。2026 年的变化是,前沿 coding agent 开始负责组织整个改进过程,过去它们更多是在既定流程里提供候选方案。
生成数据和仿真环境
模型还可以决定机器人用什么数据学习、接受什么测试,而不必直接控制机器人或修改它的代码。Qin 等人提出的四个领域中,Data 和 Environment 就属于这类工作:前者包括数据采集、标注和改进,后者包括重建场景、生成任务和搭建评测基准。
- AutoRT(Google DeepMind,2024)。先由 VLM 描述场景,再由 LLM 提出任务,最后按一份成文的“robot constitution”筛掉不安全的任务。它在多栋楼里调度了 20 多台机器人,采集了 77,000 次真实任务的执行数据。
- RoboGen(2023 至 2024 年)。agent 先提出要学什么 skill,再搭建相应的仿真场景、选择学习方法、生成训练所需的监督信号。整个过程按“提出任务、生成环境、学习”的顺序循环。
- V-CAGE(2026)。让 agent 负责生成仿真数据,替代一遇到任务失败就会中断的脚本流程。
- Gemini Robotics 2.5(2026 年 11 月)。Gemini 4 Argon 将相机拍到的真实场景重建为数字孪生,并据此生成数千次条件各异的练习。它还会分析失败视频,提出可能的原因,再到仿真和真机上测试修复方案。
仿真与现实之间的差距依然存在。《Envisioning Agentic Robotics》指出,合成数据仍有 sim-to-real gap,因此生成的环境可以补充真实部署中采集的数据,但还不能取代后者。
四条路线放在一起看
这些路线在灵巧性和通用性之间各有取舍:越少依赖训练好的运动模型,就越不需要机器人数据,但涉及物理接触的操作通常也做得越差。
| 路线 | 模型输出什么 | 是否需要机器人数据 | 擅长什么 | 主要短板 | 例子 |
|---|---|---|---|---|---|
| 1. 分层编排 | 子目标、子目标图像、抓取标记 | 需要,每个运动模型都要训练数据 | 在长流程任务中调用精细操作的 skill | 不同 policy 之间的衔接;超出工具能力范围的任务 | Gemini Robotics 2.5、带推理模型的 GR00T 2、VLAs-as-Tools、RoboHarness |
| 2. 代码作为 policy | 调用感知和控制基础功能的程序 | 不需要 | 系统集成、感知、规划、可复用的 skill | 需要快速反馈的接触操作 | CaP-X、Vals Robo-bench 中的 agent、Project Fetch |
| 3. 用约束和优化目标生成动作 | value map、关键点约束、代价函数 | 不需要 | 借助优化器实现精确的空间操作 | VLM 的空间推理能力不足,写出的要求不准确 | ReKep、VoxPoser、EmboAlign |
| 4. 直接控制 | motion chunk,每次工具调用输出一段动作 | 不需要 | 无需预先准备就能尝试新任务 | 延迟、单次动作成本、精度、安全 | Robocurve 的测试、Fable 5.2 在 RoboDojo 上的结果 |
路线开始融合,哪些问题还没有答案
这些路线已经出现了交叉。coding agent 可以把 VLA 当作一个基础功能来调用。Waddle Labs 会将前沿模型在上下文中学到的东西蒸馏成 skill,让更小、更快的模型执行。Anthropic 仍未说明 Fable 5.2 在 RoboDojo 上的结果究竟来自直接控制、代码,还是 skill 模型。运动模型本身也在加入 agent 的能力:π0.7 可以在任务中途接受指导,Physical Intelligence 的 MEM 则给 VLA 加入了语言记忆,用于完成最长约 15 分钟的任务。
还有几个问题值得继续看:
- 能力放在模型里,还是 harness 里? 规划、记忆和出错后的恢复,会继续由运动模型外部的 harness 负责,还是逐渐进入模型内部?
- 速度和成本能跟上吗? 前沿模型能否快到、便宜到足以直接处理复杂接触操作?还是始终需要下层训练好的模型来执行?
- 接口会是什么样? 推理模型与运动控制层最终会通过文本、图像(子目标图像、标记),还是代码沟通?
- 评测能否更可靠? 本文多数数字来自研发这些系统的实验室。中立评测,包括 Robocurve、Vals 和 RoboDojo 排行榜,目前规模还小,测试次数不多,设置也各不相同。
- 执行动作时如何保证安全? DeepMind 的 ASIMOV-Jailbreak 测试报告,Gemini 4 Argon 抵御越狱的比例为 99.5%,Gemini Robotics ER 2 为 82%。而 RoboHarm 的结果显示,直接控制机器人的前沿模型大多会照着有害指令行动。
演示视频与项目主页
| 路线 | 项目 | 链接 |
|---|---|---|
| 1. 分层编排 | Gemini Robotics 2.5(DeepMind) | 发布文章 |
| 1. 分层编排 | 带推理模型的 GR00T 2(NVIDIA) | 项目主页 |
| 1. 分层编排 | VoLo(NVIDIA) | 项目主页 |
| 1. 分层编排 | What Matters in Orchestrating Robot Policies | 项目主页 |
| 1. 分层编排 | π0.7(Physical Intelligence) | 项目主页 |
| 2. 代码作为 policy | Vals Robo-bench | 排行榜与运行示例 |
| 3. 用约束和优化目标生成动作 | ReKep | 项目主页 |
| 4. 直接控制 | Robocurve 的测试 | Jay Chooi 的帖子 |
| runtime 之外 | ENPIRE(NVIDIA 等) | 项目主页 |
| runtime 之外 | ASPIRE(NVIDIA 等) | 项目主页 |
参考来源
综述
- Envisioning Agentic Robotics: A New Era of Robotic Systems,Grid Robotics
- A Survey of Agentic Robotics: Toward Continual Self-Improvement,Wang、Jiang、Shen、Soh
- Towards Agentic Robots: Model, Data, Environment, and Harness,Qin 等
- Weights or Skills? A Survey of Robot-Learning Techniques,Jena 等
- Towards Embodied Agentic AI,Salimpour 等
系统与结果
- Gemini Robotics 2.5,Google DeepMind
- GR00T 2,NVIDIA GEAR
- π0.7 和 MEM,Physical Intelligence
- What Matters in Orchestrating Robot Policies
- VLAs-as-Tools、RoboHarness、VoLo、EMERGE-Policy
- CaP-X、Vals Robo-bench、Project Fetch, Phase Two (summary)
- ReKep、EmboAlign
- Inspect Robots、Robocurve: Astra vs Fable、Robocurve: Opus 5.5 vs Astra、RoboHarm
- Claude Fable 5.2 on RoboDojo,Humanoids Daily
- Waddle Labs and Robocurve, YC interview
- ENPIRE、ASPIRE、Learning While Deploying
- AutoRT、RoboGen、V-CAGE